수학·AI 개념 정리
선형대수, 미적분, 통계, 딥러닝, LLM, RAG 개념을 직접 움직여 볼 수 있는 그림과 함께 정리했습니다.
선형대수
-
벡터
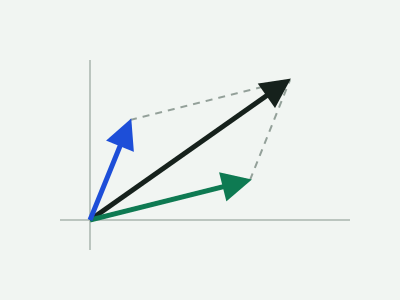
화살표를 끌어 보며 더하기, 스칼라배, 내적을 봅니다.
-
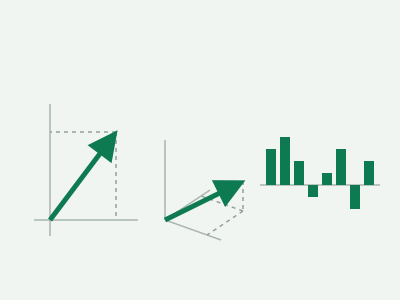
n차원 벡터
벡터는 숫자 여러 개의 묶음입니다. 2차원 밖에서는 어떻게 보는지 봅니다.
-
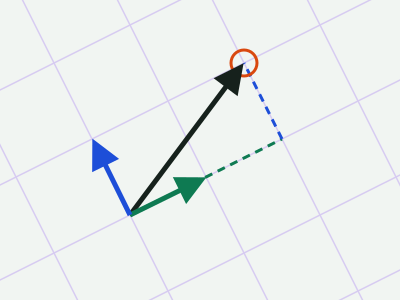
일차결합과 생성
화살표 둘로 평면의 어디까지 닿을 수 있는지 봅니다.
-
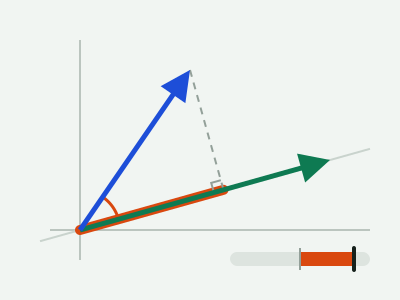
내적
두 화살표가 얼마나 같은 쪽을 보는지 숫자 하나로 봅니다.
-
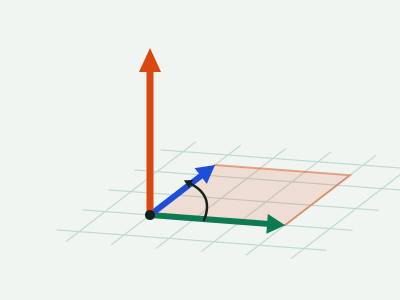
외적
두 화살표에 모두 수직인 새 화살표를 입체로 봅니다.
-
행렬 기초
m×n 크기, 원소, 전치, 덧셈과 스칼라배를 격자로 봅니다.
-
행렬 곱셈
평면을 두 번 바꾸면 순서에 따라 결과가 달라집니다.
-
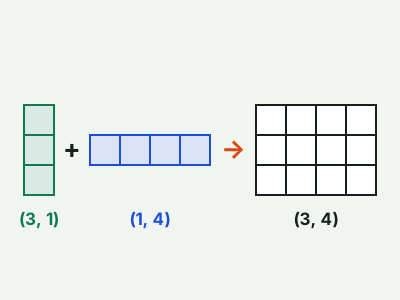
텐서와 모양: 축, shape, 브로드캐스팅
숫자를 여러 축으로 쌓은 텐서의 모양을 읽고, 모양이 다른 둘을 계산하는 브로드캐스팅을 한 축씩 따라갑니다.
-
선형변환
선형변환은 더하기와 상수배를 지키는 함수입니다.
-
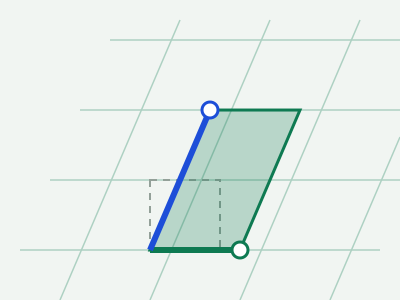
행렬식
행렬이 평면을 늘리고 뒤집을 때 넓이가 몇 배가 되는지 봅니다.
-
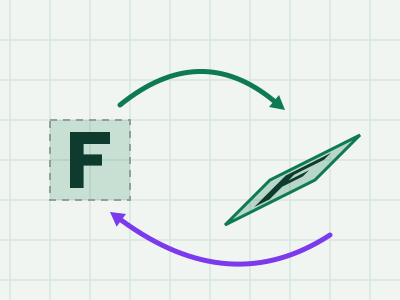
역행렬
행렬이 한 일을 되돌립니다. 되돌릴 수 없는 때도 봅니다.
-
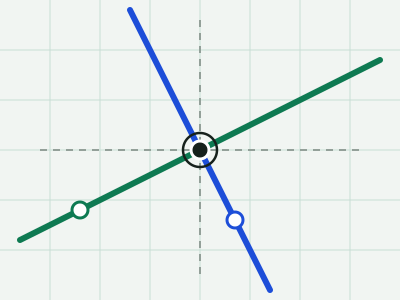
연립방정식과 소거법
직선이 만나는 점을 찾고, 소거법을 한 단계씩 따라갑니다.
-
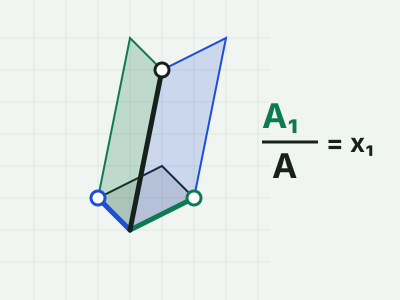
크래머 공식
크래머 공식은 연립방정식 Ax = b 의 답을 행렬식의 비 xᵢ = det(Aᵢ) ÷ det(A) 로 바로 적는 식입니다.
-
랭크
행렬을 거친 뒤 평면이 몇 차원으로 남는지 봅니다.
-
벡터공간과 부분공간
벡터공간은 더하고 상수배를 해도 그 안에 머무는 모임입니다.
-
기저와 좌표 바꾸기
기저 벡터를 바꾸면 같은 점의 좌표가 어떻게 바뀌는지 봅니다.
-
고윳값과 고유벡터
행렬을 거쳐도 방향이 그대로인 화살표를 찾습니다.
-
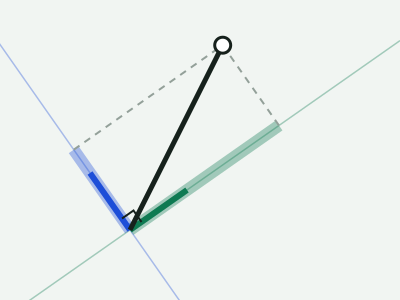
직교행렬과 내적공간
직교행렬은 열이 서로 직각이고 길이가 1 인 행렬입니다.
-
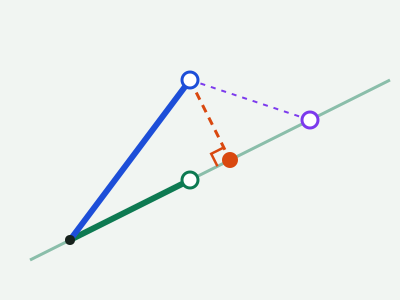
정사영과 최소제곱
점들에 가장 잘 맞는 직선을 직접 맞춰 봅니다.
-
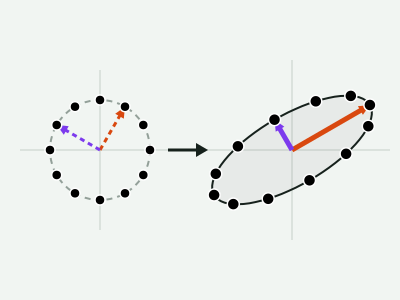
특잇값 분해(SVD)
어떤 행렬이든 돌리기, 늘리기, 돌리기로 나눠 봅니다.
미적분
-

함수와 그래프
일차, 이차, 지수, 로그의 모양을 계수를 움직여 봅니다.
-
극한과 연속
가까이 다가가면 어디에 닿는지 표와 그래프로 봅니다.
-
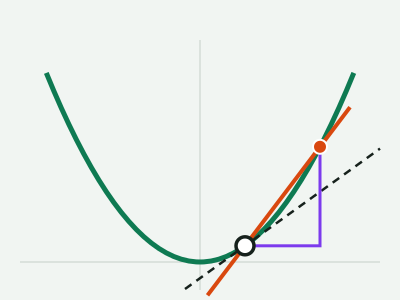
미분과 연쇄 법칙
그 자리의 기울기를 만들고, 단계가 이어질 때 곱해지는 것을 봅니다.
-
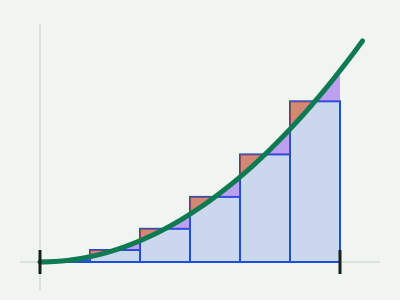
적분
잘게 나눈 막대를 더해 곡선 아래 넓이를 구합니다.
-
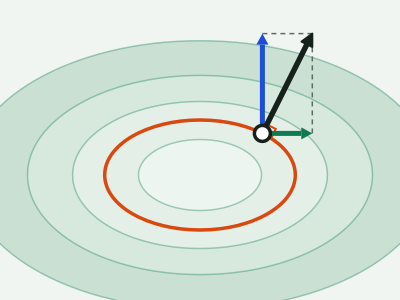
편미분과 그래디언트
지형을 한 방향씩 잘라 기울기를 보고, 가장 가파른 방향을 찾습니다.
-
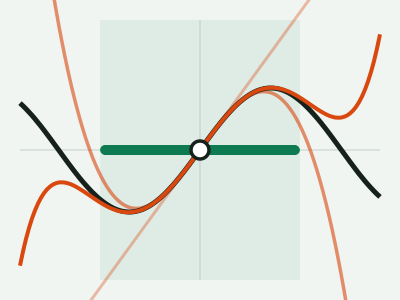
테일러 근사
항을 하나씩 더해 복잡한 곡선을 다항식으로 흉내 냅니다.
-
야코비안과 헤시안
바닥, 꼭대기, 안장점을 휘는 모양으로 가려냅니다.
확률과 정보
-
확률과 베이즈 정리
1000명의 점으로 양성 판정이 실제로 뜻하는 확률을 봅니다.
-
이항분포와 포아송 분포
n 번 가운데 몇 번 되나는 이항분포, 정해진 시간 안에 몇 번 일어나나는 포아송 분포입니다.
-
정규분포
평균과 분산, 종 모양 곡선, 더하면 종 모양이 되는 까닭을 봅니다.
-
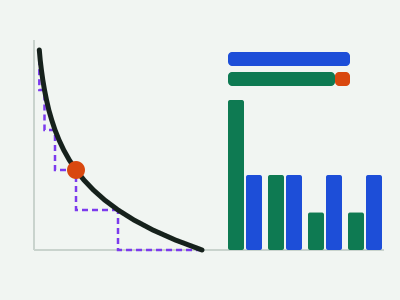
엔트로피와 교차 엔트로피
놀람을 재는 법과, 예측이 실제와 얼마나 다른지 재는 법을 봅니다.
통계 기초
-
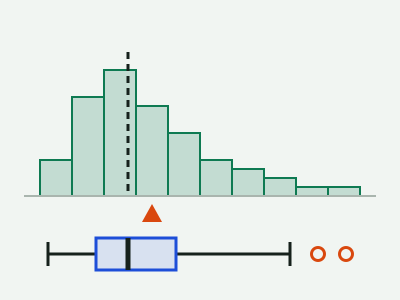
기술통계
기술통계는 숫자 더미를 몇 개의 숫자와 그림으로 줄여 한눈에 보게 하는 일입니다.
-
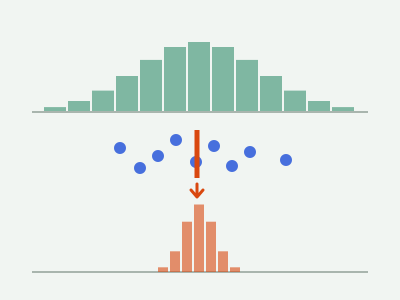
표본과 표집분포, 표준오차
모집단을 다 잴 수 없어 표본을 뽑습니다.
-
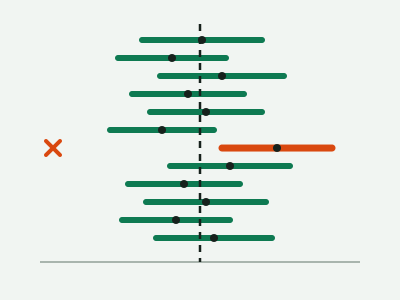
신뢰구간
신뢰구간은 표본에서 구한 추정값 둘레에 참값이 있을 만한 범위를 붙인 것입니다.
-
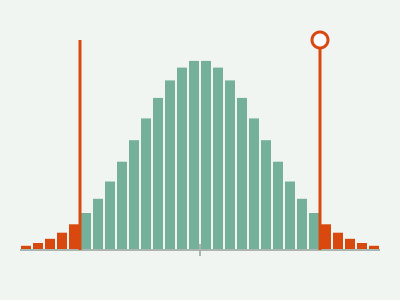
가설검정과 p값
가설검정은 「차이가 없다」고 가정해 놓고, 그 가정 아래에서 지금 본 자료만큼 치우친 결과가 얼마나 드문지 따지는 방법입니다.
-
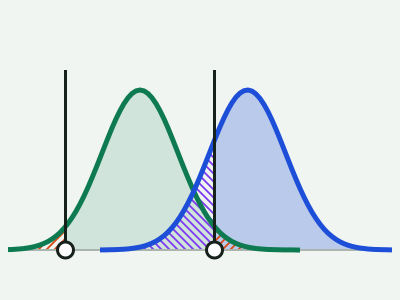
1종·2종 오류와 검정력
검정은 두 가지로 틀릴 수 있습니다.
검정 방법
-
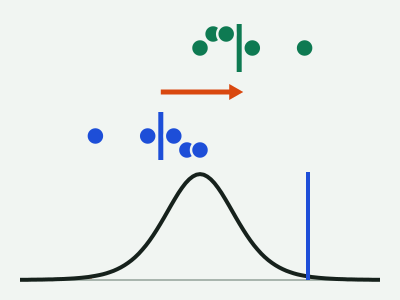
t 검정
t 검정은 평균의 차이를 그 차이가 우연히 흔들리는 폭(표준오차)으로 나눈 값 t 로 두 평균이 정말 다른지 따집니다.
-
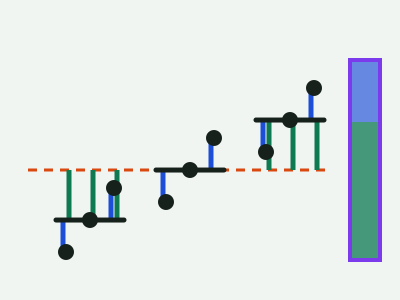
분산분석(ANOVA)
분산분석은 집단이 셋 이상일 때 평균이 모두 같은지 한 번에 따집니다.
-
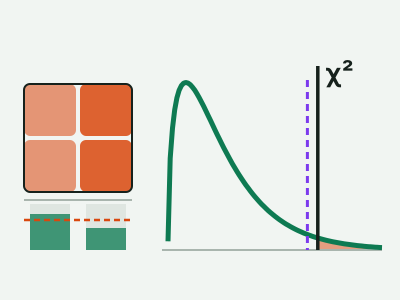
카이제곱 검정
카이제곱 검정은 「몇 명이 어느 칸에 들었나」를 센 자료가 우연이라기에 너무 많이 벗어났는지 따집니다.
-
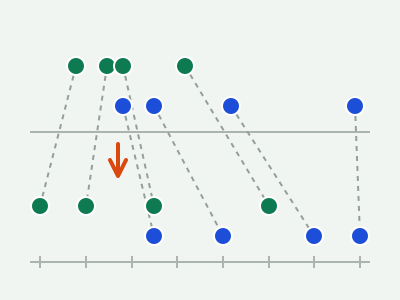
비모수 검정
비모수 검정은 자료가 종 모양이라는 가정 없이, 값 대신 순위로 비교하는 검정입니다.
-
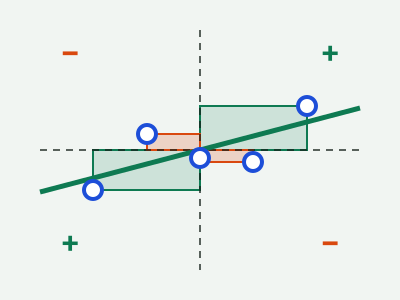
상관과 회귀
상관계수 r 은 두 값이 곧은 선에 가깝게 같이 움직이는 정도를 −1 ~ 1 로 나타냅니다.
-
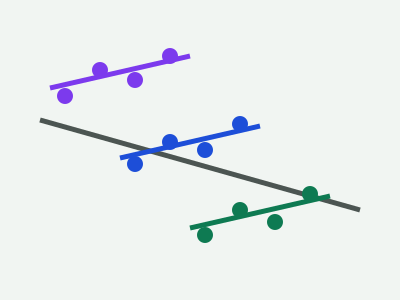
다중 회귀
다중 회귀의 계수는 다른 입력을 같게 두었을 때의 기울기입니다.
-
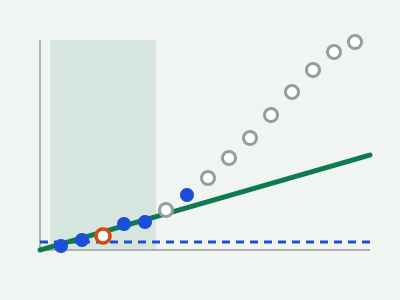
다중 비교
검정 하나에서 헛짚을 확률이 5% 여도, 검정을 20번 하면 하나쯤은 우연히 유의하게 나옵니다.
바이오 통계
-
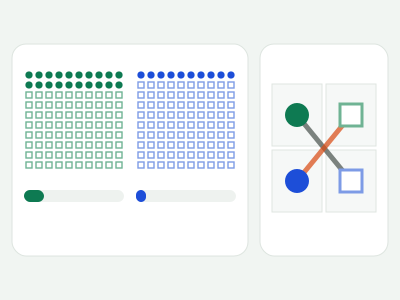
위험, 상대위험도, 오즈비
위험은 그 일이 생긴 사람의 비율, 상대위험도는 두 위험의 비, 오즈비는 두 오즈의 비입니다.
-
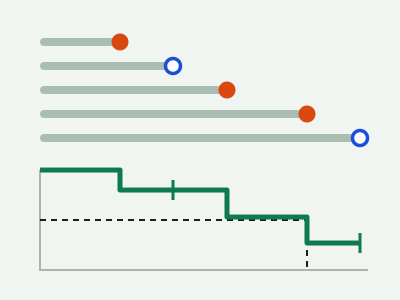
생존 분석
생존 분석은 어떤 일이 생길 때까지 걸린 시간을 다룹니다.
-
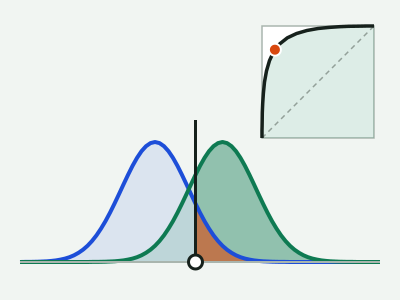
진단 검사와 ROC 곡선
검사 수치로 병이 있다·없다를 가르려면 임계값이 필요합니다.
-
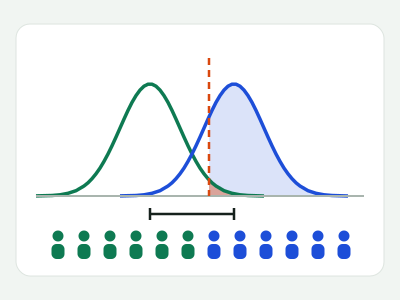
표본 크기 계산
실험 전에 찾을 가장 작은 효과, 자료의 흩어짐, α, 검정력 네 가지를 정하면 필요한 사람 수가 나옵니다.
실험계획
-
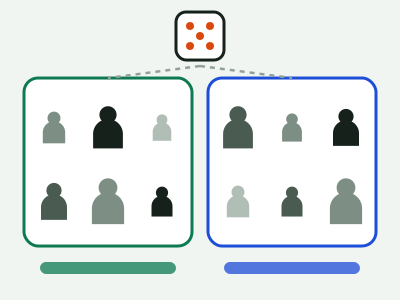
무작위 배정과 대조군
치료가 효과가 있는지 알려면 대조군과 비교해야 하고, 누가 어느 무리에 들지는 제비뽑기로 정해야 합니다.
-
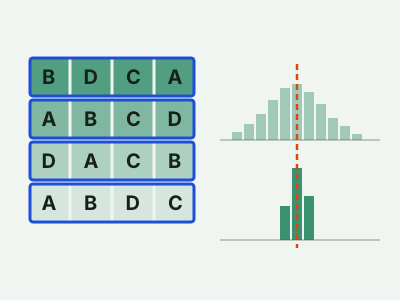
블록 설계
블록 설계는 결과에 크게 영향을 주지만 관심은 없는 것(나이, 병원, 실험한 날, 밭의 위치)으로 비슷한 것끼리 묶고, 묶음 안에서 처리를 무작위로 나누는 실험 방법입니다.
-
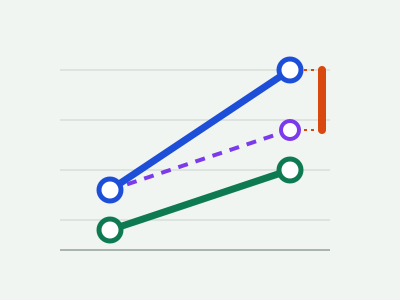
요인 설계와 교호작용
요인 설계는 알고 싶은 것(요인)이 둘 이상일 때 모든 조합을 다 시험하는 설계입니다.
-
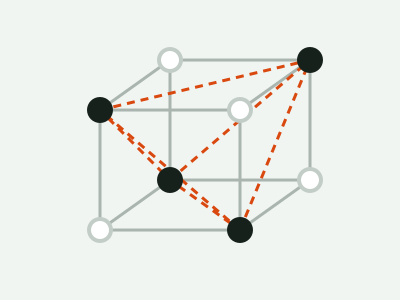
일부실시법과 교락법
요인이 많으면 모든 조합을 다 시험하기 어렵습니다.
-
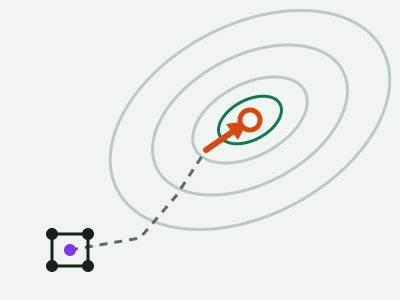
반응표면분석
반응표면분석은 조건(온도, 시간)에 따라 결과(수율)가 이루는 면을 실험 몇 점으로 어림해 가장 좋은 자리를 찾는 방법입니다.
-
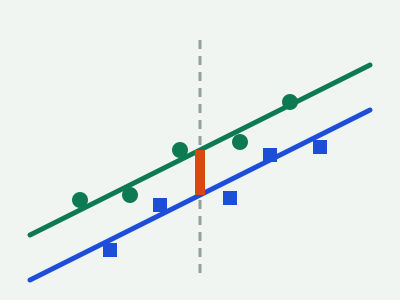
공분산분석(ANCOVA)
공분산분석은 치료 전 혈압처럼 결과를 크게 흔드는 값(공변량)으로 설명되는 만큼을 먼저 빼고 무리를 견줍니다.
-
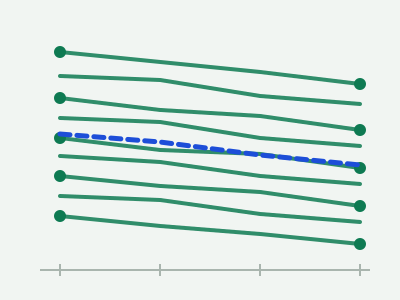
반복 측정과 교차 설계
같은 사람을 여러 번 재면 사람마다 타고난 차이를 빼고 그 사람 안의 변화만 견줄 수 있습니다.
-
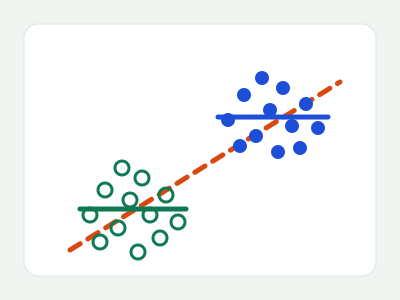
교란과 편향
교란은 원인과 결과 양쪽에 영향을 주는 셋째 요인 때문에 없는 관계가 보이는 것이고, 편향은 자료를 모으고 재는 방식 때문에 답이 한쪽으로 치우치는 것입니다.
-
임상시험 설계
임상시험은 새 치료가 안전하고 효과가 있는지 사람에게서 확인하는 실험입니다.
머신러닝
-
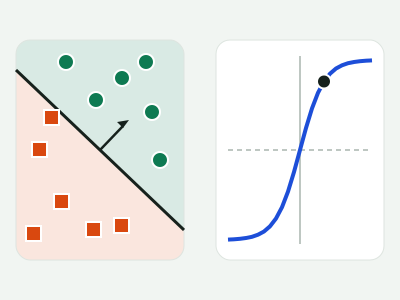
로지스틱 회귀
두 무리의 점을 가르는 선을 직접 맞추고 학습시켜 봅니다.
-
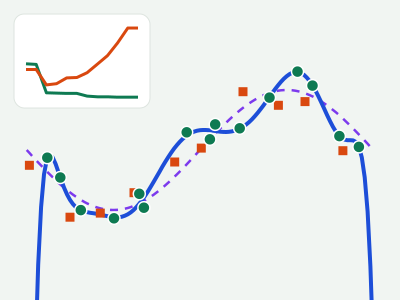
과적합과 일반화
차수를 올리면 훈련 오차는 줄고 시험 오차는 다시 느는 것을 봅니다.
-
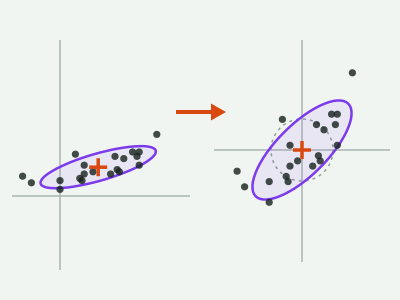
정규화와 표준화
평균을 빼고 표준편차로 나누면 구름이 어떻게 옮겨 가는지 단계별로 봅니다.
-
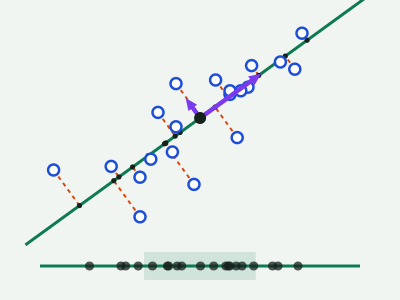
주성분 분석(PCA)
자료가 가장 넓게 퍼진 방향을 찾아 차원을 줄입니다.
-
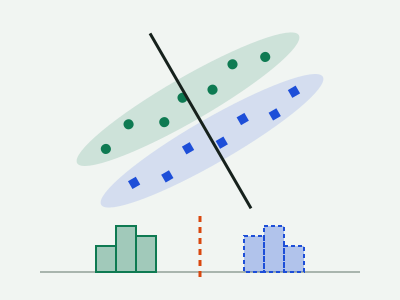
선형 판별 분석(LDA)
선형 판별 분석(LDA)은 정답(클래스)을 보고, 클래스끼리는 멀고 클래스 안에서는 모이는 방향을 찾습니다.
-
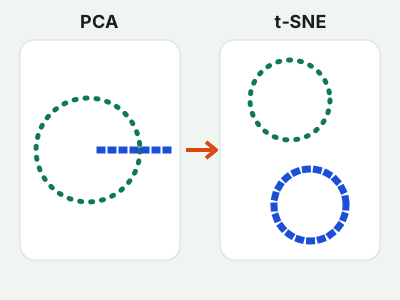
t-SNE 와 UMAP
임베딩 같은 고차원 점을 눈으로 보려면 2차원에 펴야 합니다.
-
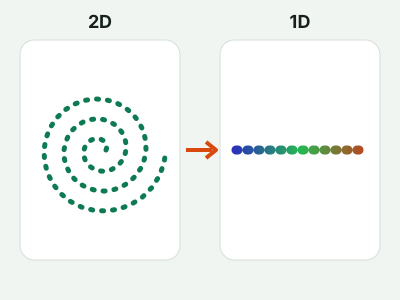
매니폴드
숫자가 수천 개인 자료도 실제로는 좁고 휘어진 면 근처에 모여 있다고 봅니다(매니폴드 가설).
-
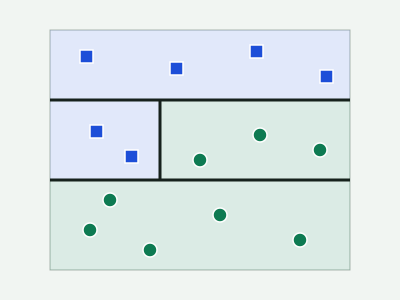
결정 트리, 랜덤 포레스트, 부스팅
결정 트리는 「이 값이 기준보다 큰가」를 이어 물어 자료를 네모 칸으로 가릅니다.
-
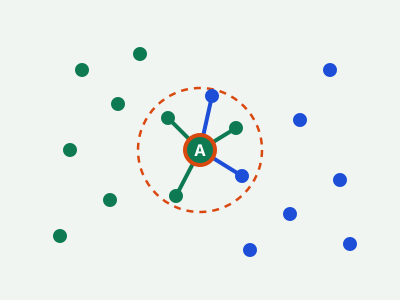
k-최근접 이웃(kNN)
가까운 점 k 개에게 물어 답을 정하는 방법과 k 가 경계를 바꾸는 것을 봅니다.
-
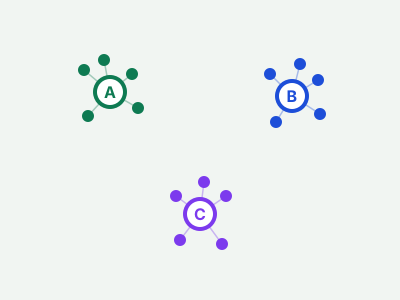
k-평균 군집
k-평균은 정답 없이 점들을 가까운 것끼리 k 개의 무리로 묶는 방법입니다.
-
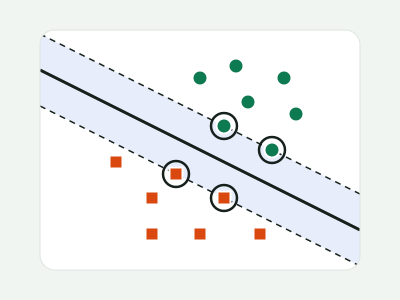
서포트 벡터 머신(SVM)
두 클래스 사이의 마진이 가장 넓은 선을 찾고, 마진을 떠받치는 점을 봅니다.
-
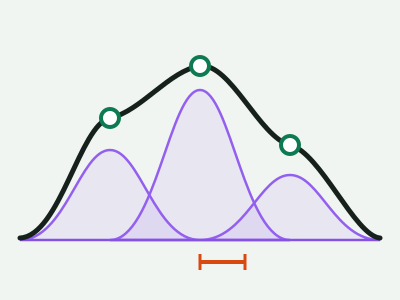
RBF
방사 기저 함수(RBF)는 중심에서 멀어질수록 작아지는 종 모양 혹입니다.
-
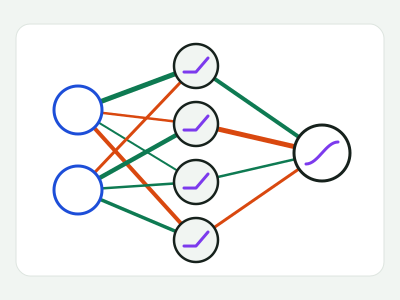
신경망
뉴런 하나에서 시작해 작은 신경망이 휜 경계를 배우는 것을 봅니다.
-
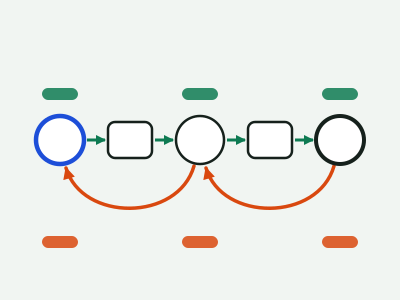
역전파
계산 그래프에서 기울기가 뒤에서 앞으로 넘어가는 것을 한 칸씩 봅니다.
-
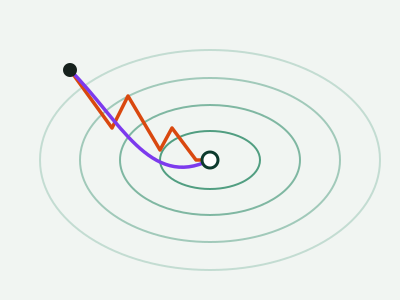
경사 하강법
공을 굴려 보며 모멘텀, 네스테로프, AdaGrad, RMSProp, Adam 을 비교합니다.
-
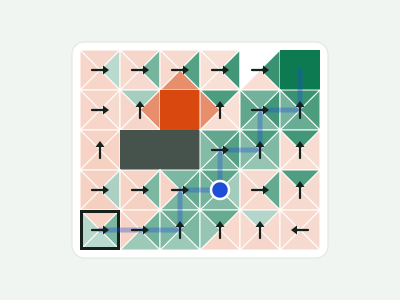
강화학습
격자 세계에서 보상만으로 길을 배워 가는 것을 봅니다.
딥러닝 학습
-
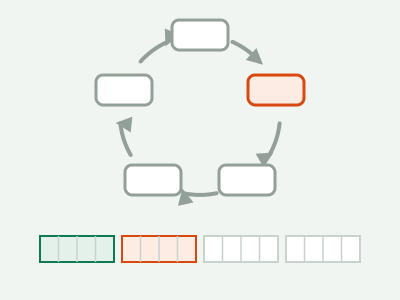
학습 루프: 한 스텝, 한 에폭
배치를 꺼내 고치고 검증하기까지, 학습 한 번의 전체 흐름을 한 칸씩 따라갑니다.
-
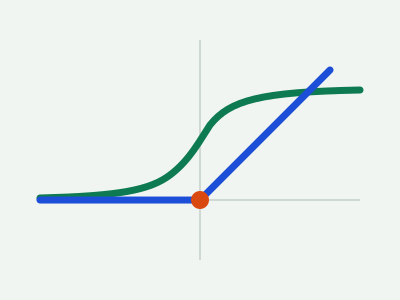
활성화 함수
활성화 함수는 뉴런의 계산을 휘게 만드는 함수입니다.
-
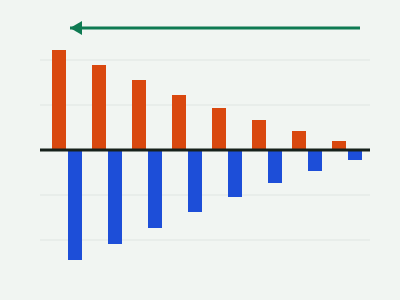
기울기 소실과 폭발
역전파는 층을 거슬러 가며 기울기에 층마다의 비율을 곱합니다.
-
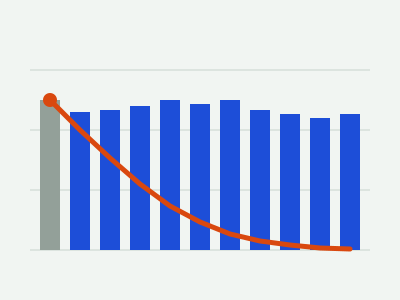
가중치 초기화
가중치를 모두 0 으로 두면 왜 배우지 못하고, 너무 크거나 작으면 왜 층을 지날수록 값이 터지거나 사라지는지 층 10개짜리 망으로 봅니다.
-
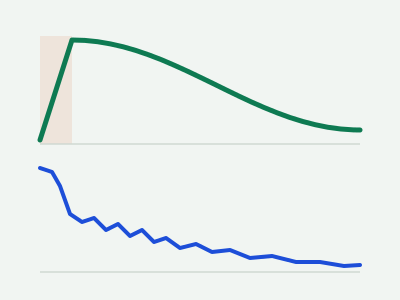
학습률 스케줄
학습률 스케줄은 스텝마다 학습률을 정하는 규칙입니다.
-
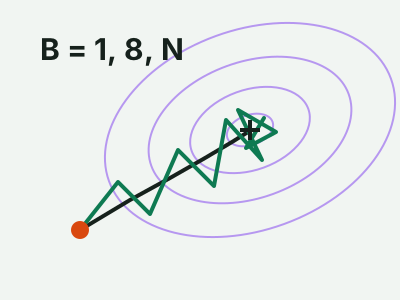
배치 크기와 기울기 누적
배치 크기는 가중치를 한 번 고칠 때 보는 예제의 수입니다.
-
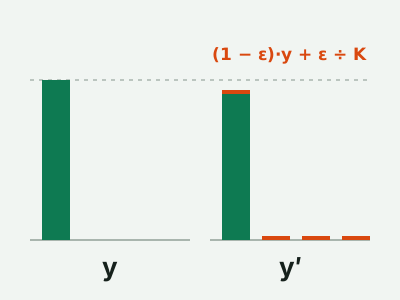
정답 표현
분류 모델에게 정답을 주는 모양을 봅니다.
-
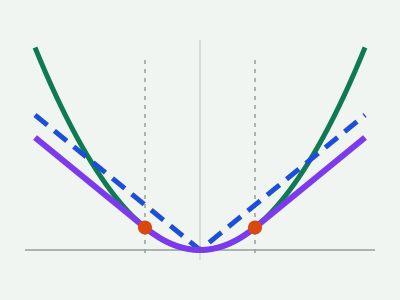
회귀의 손실
MSE 는 평균을, MAE 는 중앙값을 찾습니다.
-
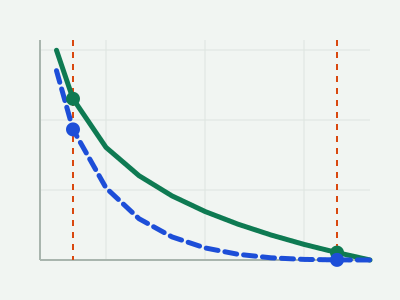
클래스 불균형
한 클래스가 훨씬 많으면 모델은 흔한 쪽만 맞혀도 정확도가 높고, 손실도 흔한 쪽이 차지합니다.
-
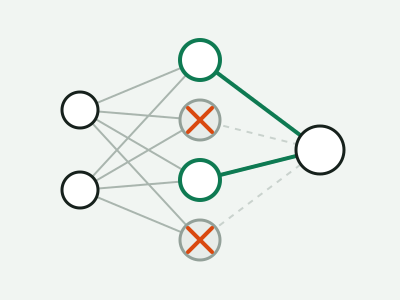
드롭아웃
드롭아웃은 학습할 때마다 뉴런 일부를 무작위로 꺼서 과적합을 줄입니다.
-
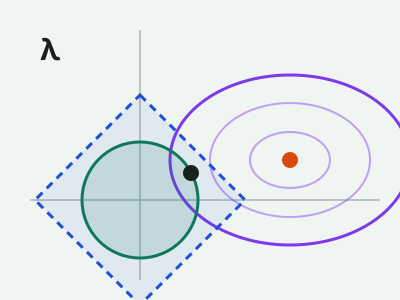
가중치 감쇠와 L1·L2 규제
손실에 가중치 크기의 벌점을 더하면 최솟점이 0 쪽으로 옮겨 갑니다.
-
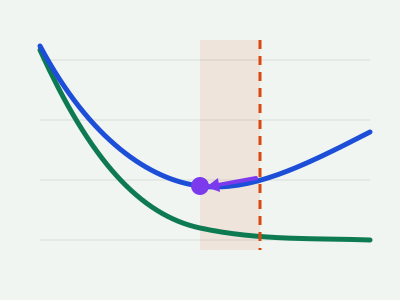
조기 종료와 학습 곡선 읽기
학습 손실과 검증 손실 곡선을 같이 보면 덜 배웠는지, 외우기 시작했는지, 학습률이 큰지 알 수 있습니다.
-
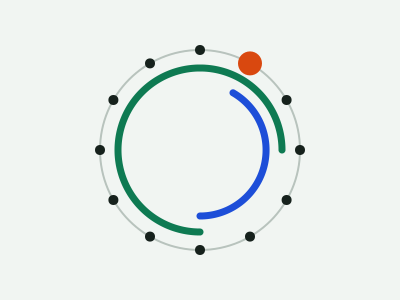
그로킹: 외운 뒤에 뒤늦게 깨우치기
훈련 자료를 다 외운 한참 뒤에야 시험 점수가 오르는 현상과, 모델이 찾은 원 위의 덧셈을 봅니다.
-
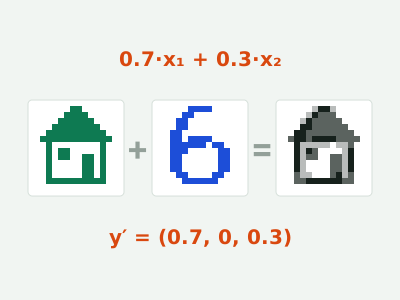
데이터 증강
데이터 증강은 가진 훈련 자료를 조금씩 바꿔 연습 문제를 늘리는 일입니다.
-
전이 학습과 미세 조정
전이 학습은 다른 과제에서 이미 배운 모델을 가져와 새 과제에 맞추는 일입니다.
-
자기지도 학습: 라벨 없이 표현 배우기
대조 학습의 손실을 손으로 풀고, 사진을 가려 되살리는 방식과 견줍니다.
-
메트릭 러닝: 거리를 학습하기
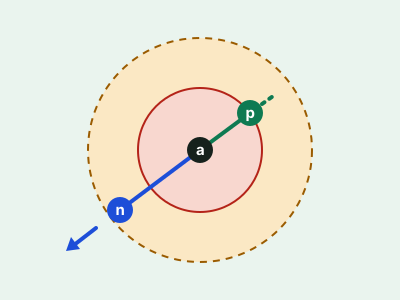
같은 것은 가깝게, 다른 것은 멀게 놓는 삼중항 손실을 점 셋으로 따라갑니다.
모델 구조
-
합성곱과 CNN
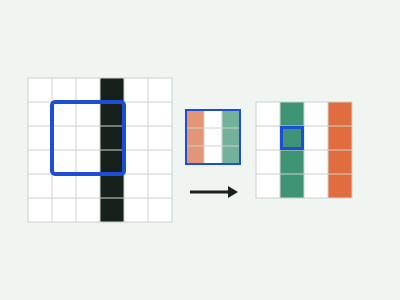
작은 필터가 그림 위를 미끄러지며 가장자리를 찾는 것을 봅니다.
-
풀링과 수용 영역
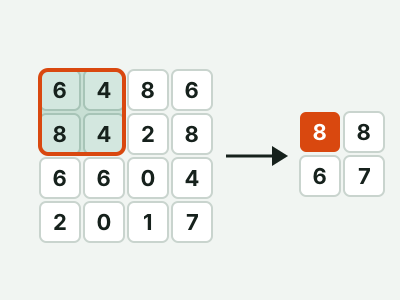
풀링은 격자 위에 창을 놓고 창 안의 값을 하나로 요약해 크기를 줄이는 층입니다.
-
CNN 구조 읽기
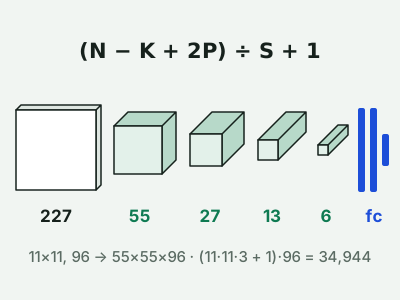
논문의 CNN 층별 표는 어떻게 읽나요? 필터 크기·개수·걸음·패딩은 논문이 정한 값이고, 출력 크기는 (N − K + 2P) ÷ S + 1, 파라미터 수는 (K·K·C_in + 1)·C_out 으로 계산합니다.
-
배치 정규화와 레이어 정규화
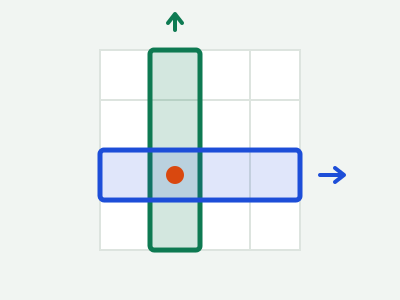
배치 정규화와 레이어 정규화는 식이 같고 평균·분산을 내는 방향만 다릅니다.
-
잔차 연결(ResNet)
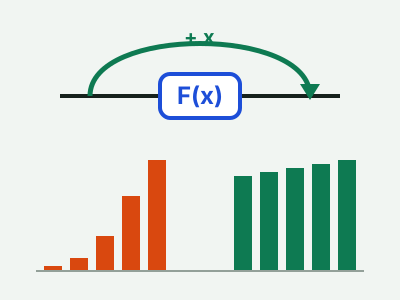
잔차 연결은 층의 출력에 입력을 그대로 더하는 스킵 연결입니다.
-
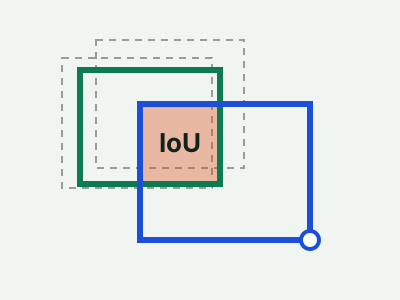
객체 탐지
객체 탐지는 그림 속 물체마다 상자와 이름, 확신 점수를 내는 일입니다.
-
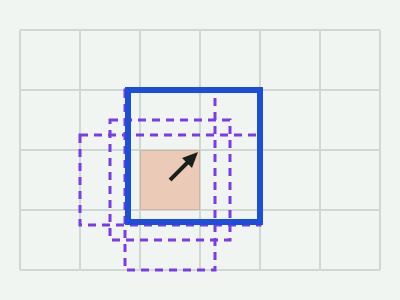
탐지기의 구조: R-CNN 계열과 YOLO
분류 신경망이 어떻게 상자를 내는지 두 단계 방식과 한 단계 방식으로 따라갑니다.
-
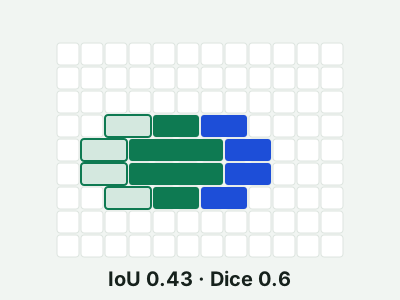
영상 분할
영상 분할은 사진의 픽셀마다 클래스를 매기는 일입니다.
-
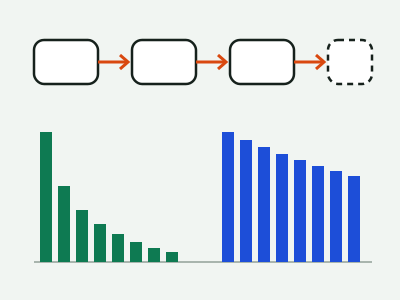
RNN 과 LSTM
RNN(순환 신경망)은 순서가 있는 자료를 한 칸씩 읽으며 상태를 다음 칸에 넘깁니다.
-
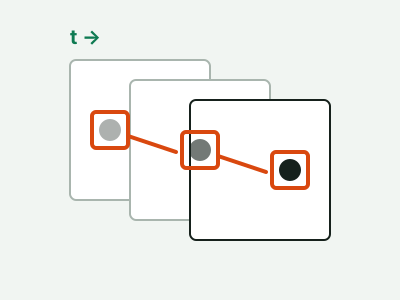
비디오 분류: 시간 축을 더한 합성곱
프레임마다 보는 필터와 시간으로도 미끄러지는 3D 필터가 움직임을 어떻게 다르게 보는지 봅니다.
-
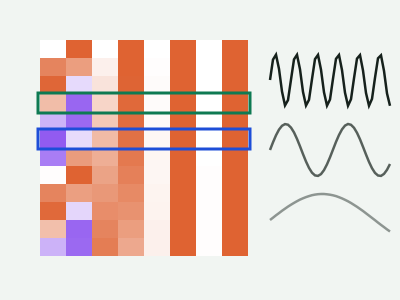
위치 인코딩
어텐션은 낱말의 차례를 섞어도 결과가 같습니다.
-
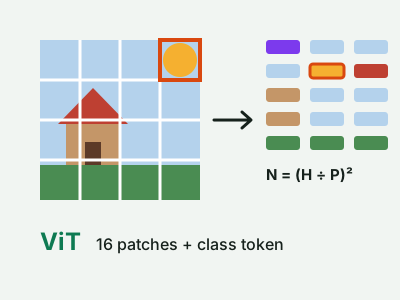
비전 트랜스포머(ViT)
비전 트랜스포머(ViT)는 그림을 패치로 잘라 패치 하나를 낱말 하나처럼 트랜스포머에 넣습니다.
-
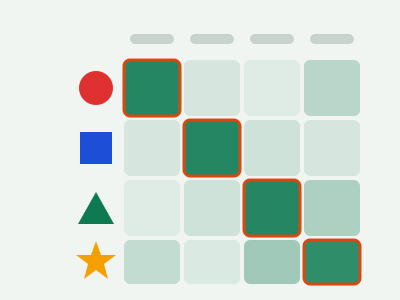
멀티모달 학습: CLIP 이 그림과 글을 한 공간에 놓는 법
이미지와 텍스트의 유사도 행렬에서 손실을 내고, 학습 없이 클래스를 더하는 제로샷 분류를 봅니다.
-
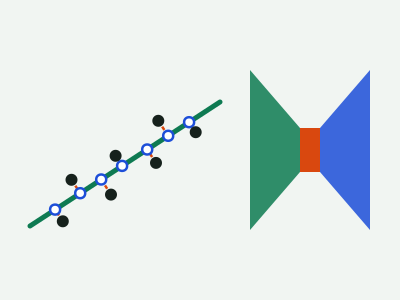
오토인코더와 VAE
오토인코더는 자료를 좁은 병목으로 눌렀다가 다시 만들게 해서 압축을 배웁니다.
-
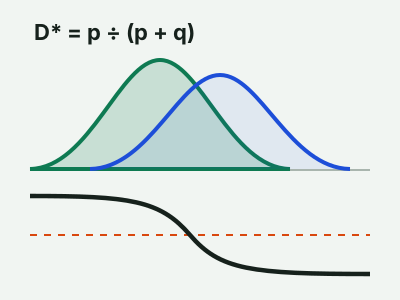
GAN
GAN 은 가짜를 만드는 생성자와 진짜·가짜를 가려내는 판별자를 겨루게 해 학습합니다.
-
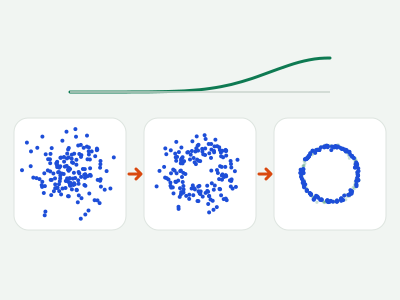
확산 모델
점 그림에 노이즈를 넣었다가 거꾸로 걷어 내며 모양을 되살립니다.
-
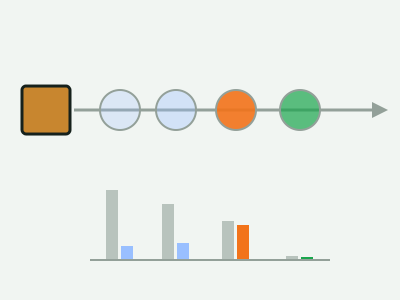
3D 비전: 복셀, 포인트 클라우드, NeRF
3D 를 담는 꼴들을 견주고, 광선 하나의 볼륨 렌더링을 한 표본씩 계산합니다.
-
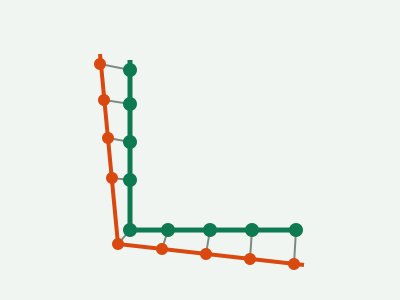
정합: 강체에서 비강체까지
두 점 무리를 겹치는 ICP 를 한 걸음씩 따라가고, 회전·이동만으로 맞출 때와 휘어서 맞출 때를 비교합니다.
평가와 운영
-
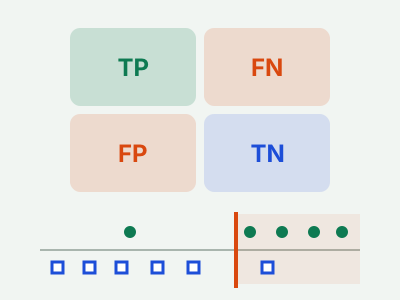
혼동 행렬, 정밀도·재현율·F1
분류 모델의 맞음과 틀림을 네 칸(TP, FP, FN, TN)으로 세고, 정확도가 속는 경우, 정밀도와 재현율, F1 이 산술 평균이 아니라 조화 평균인 까닭, 기준값을 옮기면 둘이 맞바뀌는 것, 다중 클래스의 macro·micro 평균을 점 30개를 끌며 익힙니다.
-
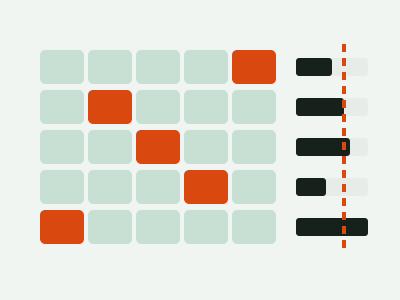
자료 나누기와 데이터 누수
모델의 점수는 학습에 쓰지 않은 자료로 재야 믿을 수 있습니다.
-
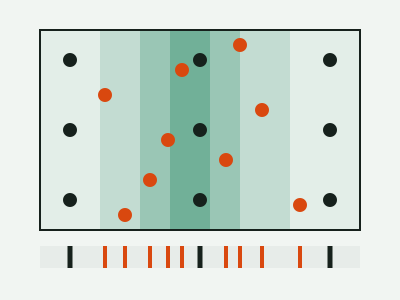
하이퍼파라미터 찾기: 그리드 서치와 랜덤 서치
하이퍼파라미터를 여러 번 바꿔 보고 검증 점수로 고르는 두 방법을 견줍니다.
-
보정
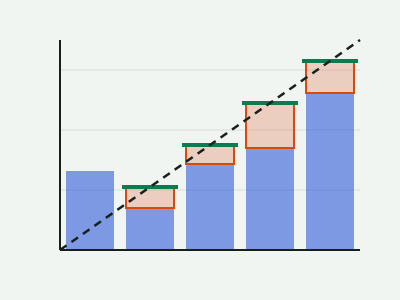
모델이 90% 라고 한 예측 가운데 실제로 90% 가 맞을까요? 지어낸 예측 200개로 신뢰도 그림을 그리고, 온도 T 를 바꿔 막대가 대각선에 붙는 것을 보며, 기대 보정 오차(ECE) 식이 만들어지는 과정을 숫자로 따라갑니다.
-
양자화
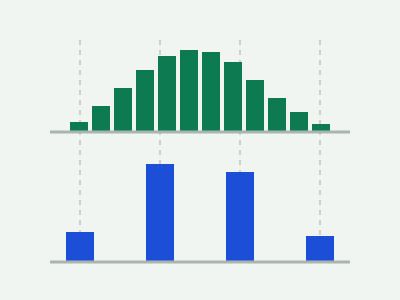
양자화는 모델의 가중치를 32비트 실수 대신 8비트·4비트 정수로 적어 모델을 작고 빠르게 만드는 일입니다.
-
자료 분포 변화(드리프트)와 운영 감시
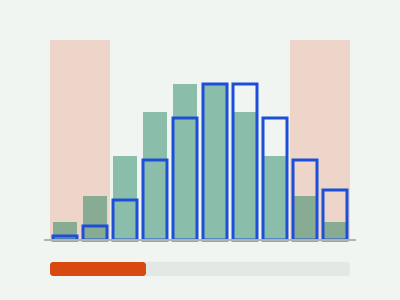
배포한 모델은 코드가 그대로여도 나빠질 수 있습니다.
LLM
-
토큰화
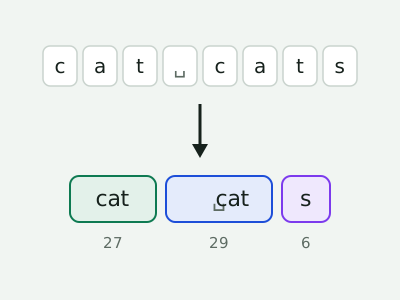
글이 조각으로 잘리는 과정을 한 번씩 합쳐 가며 봅니다.
-
임베딩
낱말 지도에서 가까운 낱말을 찾고 낱말 산수를 해 봅니다.
-
어텐션
낱말이 다른 낱말을 얼마나 참고하는지 계산을 한 단계씩 봅니다.
-
트랜스포머와 LLM
토큰에서 다음 토큰의 확률까지, 글이 만들어지는 흐름을 따라갑니다.
-
인코더와 디코더: 트랜스포머의 세 갈래
인코더만, 디코더만, 둘 다 쓰는 구조가 무엇을 보고 무엇을 내는지 견줍니다.
-
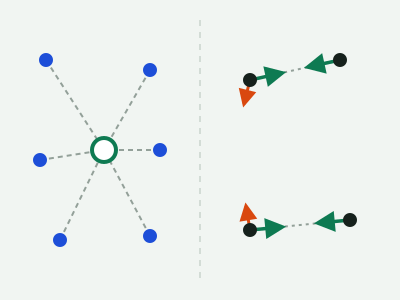
임베딩 모델: 문장을 벡터 하나로
토큰 벡터를 하나로 모으고, 비슷한 문장끼리 가깝게 학습하는 것을 봅니다.
-
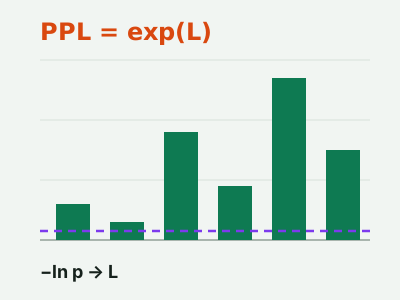
LLM 은 어떻게 학습하나
LLM 은 글의 다음 토큰을 맞히며 배웁니다.
-
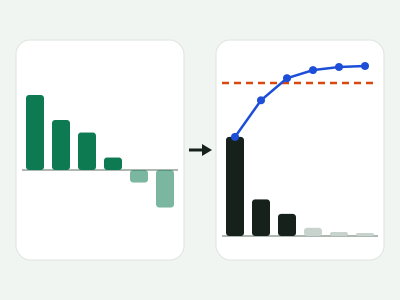
소프트맥스와 샘플링
온도, top-k, top-p 가 다음 토큰 고르기를 어떻게 바꾸는지 봅니다.
-
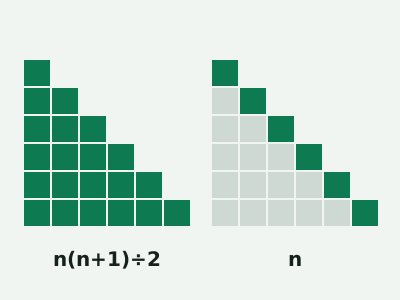
컨텍스트 윈도우와 KV 캐시
컨텍스트 윈도우는 언어 모델이 한 번에 볼 수 있는 토큰 수(입력 + 출력)입니다.
-
구조화된 출력
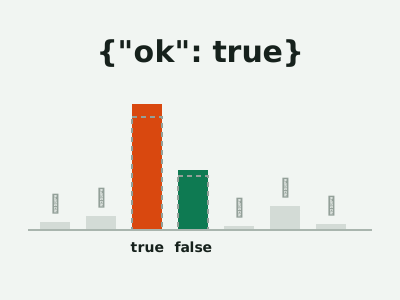
LLM 에게 정해진 모양(JSON, 스키마)으로 답하게 하는 세 가지 길: 프롬프트로 부탁하고 검증하기, JSON 모드·도구 호출, 제약 디코딩. 문법 밖의 토큰을 가리고 다시 나누는 식 p′ᵢ = pᵢ·mᵢ ÷ Σ pⱼ·mⱼ 를 한 단계씩 만들고, 무엇이 보장되고 무엇이 안 되는지 봅니다.
-
미세 조정과 LoRA
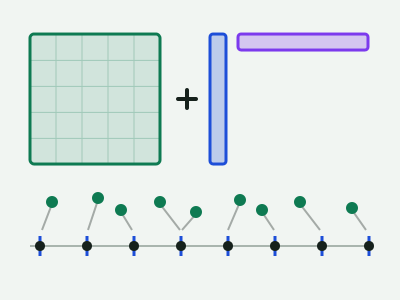
큰 행렬의 변화를 작은 행렬 둘로 대신하는 것과 양자화를 봅니다.
-
환각과 LLM 평가
환각은 언어 모델이 그럴듯하지만 틀린 내용을 지어내는 것입니다.
RAG 와 에이전트
-
RAG
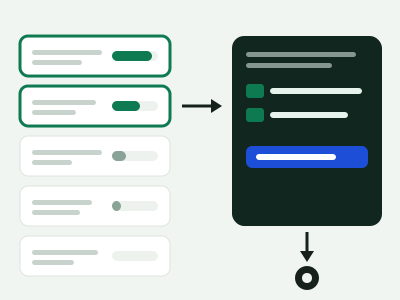
질문에 맞는 조각을 찾아 프롬프트에 넣기까지의 흐름을 따라갑니다.
-
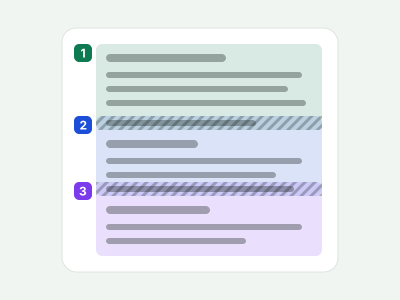
청킹
청크 크기와 오버랩을 바꿔 가며 답이 잘리는지 봅니다.
-
벡터 검색
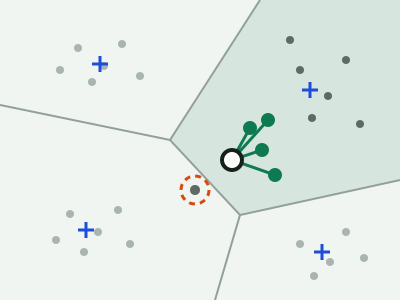
가장 가까운 점을 다 재서 찾는 법과 빨리 어림하는 법을 비교합니다.
-
키워드 검색과 하이브리드
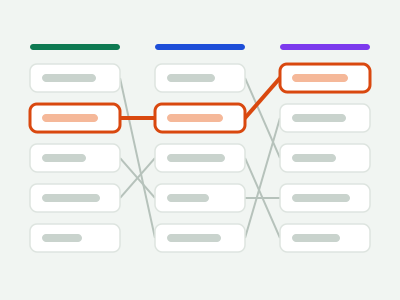
BM25 점수를 뜯어보고, 벡터 순위와 합쳐 봅니다.
-
검색 평가
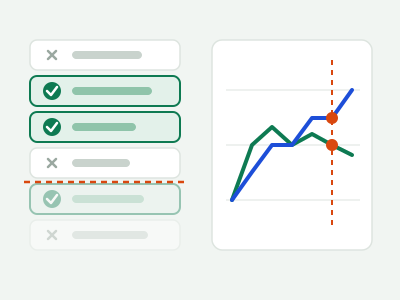
결과를 맞음·틀림으로 바꿔 가며 정밀도, 재현율, MRR, nDCG 를 계산합니다.
-
AI 에이전트
LLM 이 도구를 부르고 결과를 보고 다음을 정하는 되풀이를 한 단계씩 봅니다.
정렬과 탐색
-
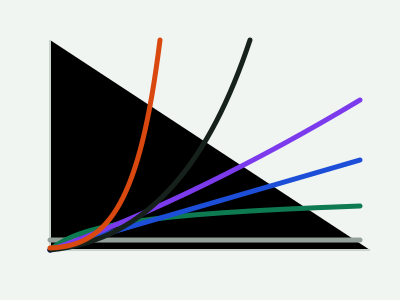
시간 복잡도(빅오)
자료가 늘면 걸음 수가 어떻게 느는지 여섯 곡선으로 봅니다.
-
기초 정렬: 버블·선택·삽입
막대 8개가 세 방법으로 정렬되는 것을 한 걸음씩 봅니다.
-
병합 정렬과 퀵 정렬
나눠서 정렬하고 합치는 두 방법을 한 걸음씩 봅니다.
-
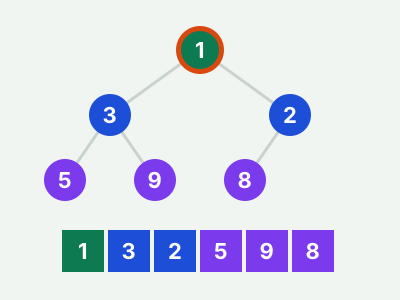
힙과 우선순위 큐
나무와 배열을 나란히 놓고 넣기와 꺼내기를 따라갑니다.
-
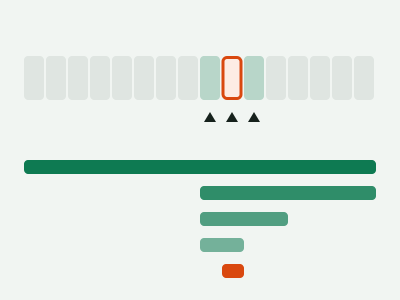
이진 탐색
정렬된 칸에서 반씩 잘라 찾는 것을 한 걸음씩 봅니다.
-
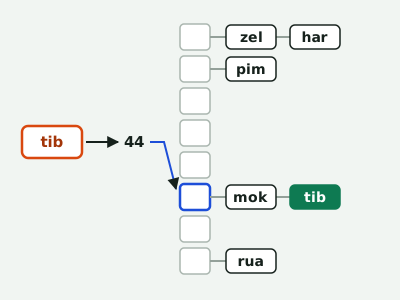
해시 테이블
낱말이 숫자가 되어 칸을 찾아가고, 같은 칸에 겹치는 것을 봅니다.
트리와 그래프
-
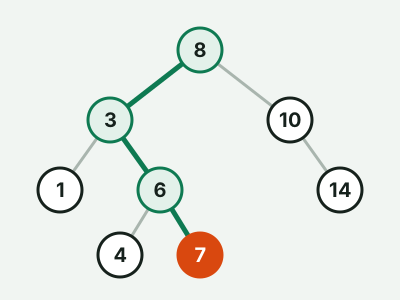
이진 탐색 트리
넣기·찾기·지우기를 따라가고, 넣는 순서가 나무의 모양을 정하는 것을 봅니다.
-
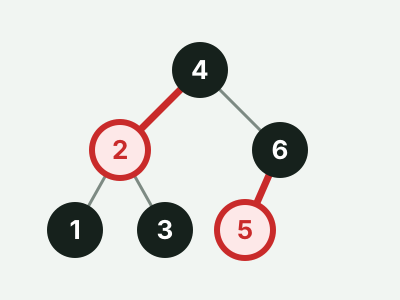
레드블랙 트리
넣을 때마다 회전하고 색을 바꿔 균형을 맞추는 것을 한 걸음씩 봅니다.
-
그래프 탐색: 너비·깊이 우선
큐와 스택이 가는 순서를 어떻게 바꾸는지 그래프와 미로에서 봅니다.
-
위상 정렬
먼저 해야 하는 일이 있을 때 순서를 정하는 것을 한 걸음씩 봅니다.
-
다익스트라
가까운 정점부터 확정하며 최단 경로를 찾는 것을 따라갑니다.
-
최소 신장 트리: 크루스칼·프림
모든 마디를 가장 싸게 잇는 두 방법을 한 걸음씩 봅니다.